Текстовый монтаж видео через LLM: экономия токенов ценой визуального контроля
Проект video-use от browser-use монтирует видео, читая транскрипт с таймкодами, а не кадры. Это сокращает объём токенов на порядки, но модель видит картинку лишь выборочно. Разбираем механизм, ограничения и реальную стоимость стека.
Видео без просмотра: что на самом деле даёт текстовый монтаж через LLM
Часовое видео при 30 кадрах в секунду — это 108 000 кадров. Если отдать модели каждый кадр по 1500 токенов, выйдет около 162 млн токенов. Проект video-use от browser-use идёт другим путём: модель читает текст, а не кадры. Транскрипт с таймкодами по словам упаковывается в файл takes_packed.md размером около 12 КБ на час видео. По расчётам авторов, наивный подход дал бы около 45 млн токенов на 30 000 кадров, а здесь выходит 12 КБ текста и горсть PNG.
Разрыв в объёме — главный сюжет. Но вокруг него собран стек, который в интенте назван «самым мощным бесплатным». Ни один источник бесплатность не подтверждает. RunPod оплачивается за pod, Cursor и Claude Code стоят от $20 в месяц, Kling работает на кредитах.
Как модель монтирует, не глядя на видео
Пайплайн video-use состоит из шести шагов. Сначала Transcribe: ElevenLabs Scribe выдаёт транскрипт с таймкодами по словам, четыре параллельных воркера, результат кешируется в transcripts/<name>.json. Потом Pack: строка выглядит так: [002.52-005.36] S0 Ninety percent of what a web agent does is completely wasted. Дальше LLM Reasons — sub-agent выбирает дубли и неудачные дубли. Затем EDL, список правок в JSON с полями source, start, end, beat, quote, reason, grade, overlays. Render собирает ffmpeg: цветокоррекция по сегментам, lossless concat, субтитры в самом конце. И Self-Eval, который проверяет результат до трёх итераций.
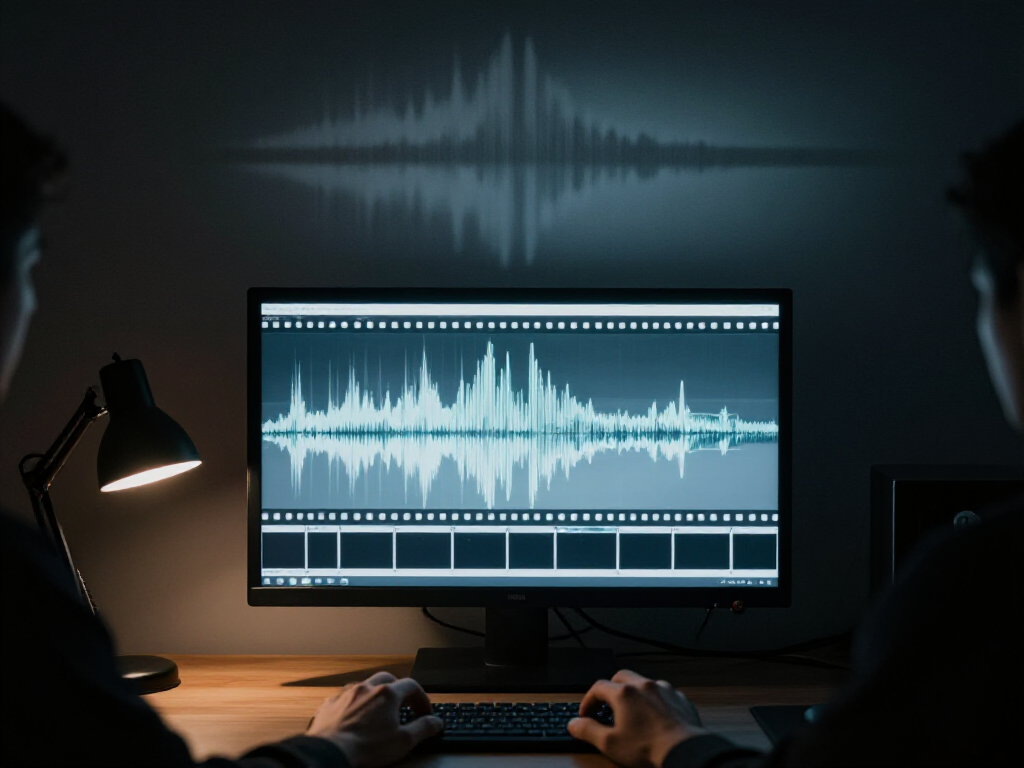
«Не смотрит» здесь нужно уточнить. В точках решений агент вызывает хелпер timeline_view, который собирает PNG с filmstrip, waveform и метками слов. Кадры модель видит выборочно, по запросу, а не сканирует весь материал. Экономия токенов держится на том, что картинка подключается только там, где без неё нельзя.
Self-Eval показывает, где текстовый подход упирается в звук и картинку. Он ищет скачки на склейках и пики в waveform. Fade в 30 миллисекунд может не закрыть щелчок на стыке, и по тексту щелчок не виден — агент должен поймать его сам. Из этого следует, что чтение по тексту годится для роликов с речью и плохо подходит для видео без слов, где главный вход — картинка и звук. В источниках это прямо не сказано, но так следует из устройства пайплайна.
RunPod и Cursor: где всё ломается
LLM поднимается на RunPod pod, а в Cursor в настройках OpenAI API Key вставляется proxy-URL вида https://[pod ID]-5000.proxy.runpod.net/v1. Завершающий слэш — типичная причина, по которой подключение молча не работает. Вторая частая причина — порт 5000 не открыт в конфигурации pod. Серверы для моделей — text-generation-webui или kobold.cpp; для GGUF подойдёт второй.
Если подключение есть, но модель отвечает медленно или падают таймауты, обычно не хватает VRAM. Совет источников — квантизация GGUF или более мощный GPU, то есть опять деньги. Приватность кода здесь реальна только до определённой точки. Если модель живёт на RunPod, код не уходит внешним провайдерам. Но если MCP-сервер или запросы идут наружу, защита неполная, и источник прямо на это указывает.
Разгон: дёшево на бумаге, долго на практике
На другом конце спектра — сервис, который собирает ролик по сценарию. Claude с коннектором NexLev анализирует YouTube-каналы, Vidrush собирает видео: озвучка Eleven Labs, стоковые кадры, эффекты. Ролик примерно на 23 минуты стоит 1234 кредита. На тарифе Starter за $99 в месяц это около $62,5 за видео. Альтернативный сервис, по словам источника, делает такой же ролик за $7–8, и монтаж занимает около 20 минут.
Напрямую эти цифры сравнивать нельзя: сервисы разные, тарифы разные, и разница в модели оплаты важнее разницы в цене. Сам Vidrush в бете, по вайтлисту.
Процесс тоже не так гладок, как обещает реклама. Четыре промпта в Claude, Opus вместо Sonnet ради «живости» текста, три–пять чужих сценариев в качестве референса. Рендер занимает 40–60 минут, и если что-то не устроило, правки идут слой за слоем. Источник предупреждает: 50 роликов в мёртвой нише не наберут просмотров. Ниша должна поддаваться визуализации — стоки, архив, съёмка.
Что выдерживает проверку
Самый честный вывод из материала такой: текстовое чтение экономит токены, но платит за это слепотой к визуалу. Модель видит картинку только в тех точках, которые сама отметит. Для роликов с речью и стоками стек годится как прототип. Для сложного монтажа без речи и для проектов с жёсткими требованиями к приватности и бюджету без доработки он не подходит.
Автономного монтажа без проверки человеком не получается. Self-Eval после трёх итераций может оставить нерешённые проблемы, и агент сам о них сообщает. Измерений качества, времени и надёжности в источниках нет: неизвестно, сколько раз агент доходил до третьей итерации и насколько стабилен рендер на RunPod. Поэтому говорить о «самом мощном» стеке пока не на чем.