Воронка Карпати: почему экспонента ИИ проходит мимо 99,8% человечества
Шесть миллиардов человек никогда не взаимодействовали с языковыми моделями. Еще один-два миллиарда хотя бы раз написали запрос в бесплатный ChatGPT. Около двадцати миллионов используют агентов в работе. И примерно пять тысяч человек имеют доступ к внутренним системам OpenAI. Андрей Карпати объясняе…
Воронка Карпати: почему экспонента ИИ проходит мимо 99,8% человечества
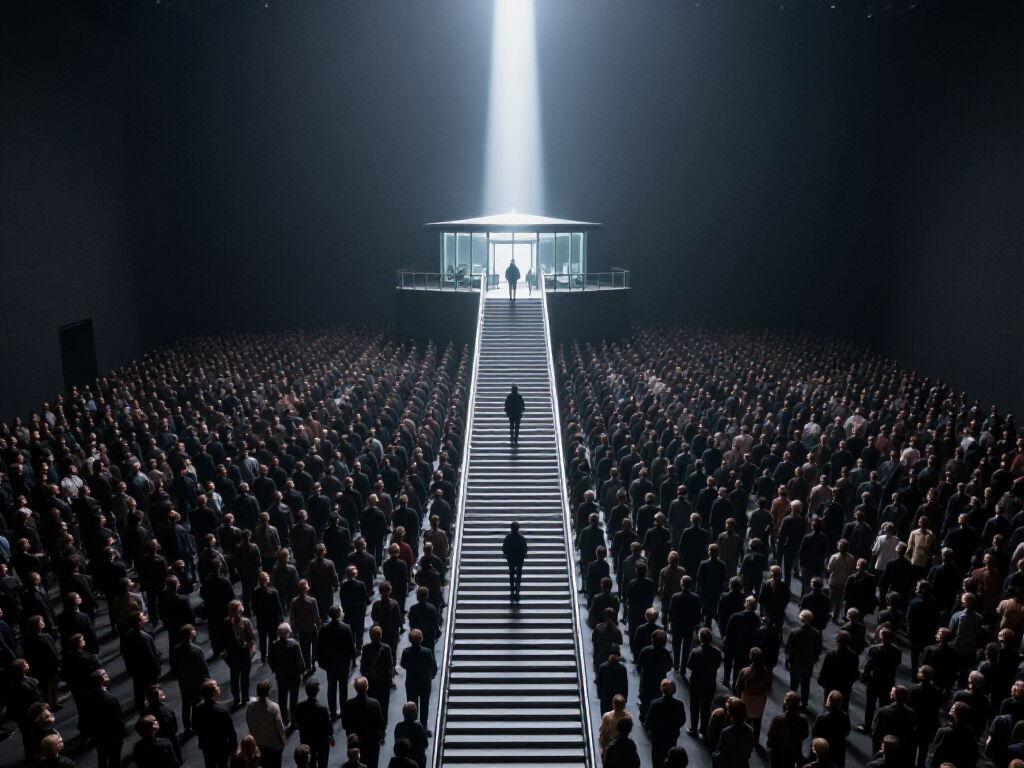
Шесть миллиардов человек никогда не взаимодействовали с языковыми моделями. Еще один-два миллиарда хотя бы раз написали запрос в бесплатный ChatGPT — «составь поздравление», «напиши письмо». Около двадцати миллионов используют агентов в работе: программирование, наука, крупные проекты. И примерно пять тысяч человек — 0,00006% населения — имеют доступ к внутренним системам OpenAI, которые ищут уязвимости в чужом ПО, атакуют платформы и месяцами работают над математическими задачами, на которые у лучших специалистов ушли бы годы.
Эти цифры привел Андрей Карпати, сооснователь OpenAI, бывший ведущий разработчик автопилота Tesla и автор самого известного курса по глубокому обучению. Человек, который видит обе крайности: и то, что делает ChatGPT в браузере у обычного пользователя, и то, на что способны системы с внутренним доступом. Разрыв между ними настолько велик, что напрашивается вопрос: экспоненциальный рост ИИ вообще происходит — или это оптическая иллюзия узкой группы инсайдеров?
Карпати утверждает, что рост реален. Просто он направлен не туда, куда смотрит большинство.
Механизм неравномерности он раскладывает на три фактора. Первый — масштаб задачи. «Напиши короткий текст» и «реализуй проект, над которым команда работала бы недели» — это разные виды деятельности, а не степени одной. Второй — неравномерность развития моделей по областям. Ключевую роль играет обучение с подкреплением, которое работает только там, где результат можно проверить автоматически. Код проверяется модульными тестами — поэтому программирование ушло далеко вперед. Качество текста или поиск информации объективной проверке не поддаются — поэтому «поздравления» остались примерно на том же уровне, что и год назад. Третий фактор — доступ: бесплатная версия, платная подписка и внутренний инструмент — это три разные технологии под одним названием.
Из этой связки следует неочевидный вывод. Разрыв между группами — не техническое ограничение, которое со временем закроется, а экономическая конструкция. Компании вкладываются туда, где результат проверяем и монетизируем. Стимулов «улучшать поздравления» нет и не появится. Бесплатный пользователь видит не устаревшую версию будущего, а принципиально другую траекторию развития — и эта траектория не ведет туда же, куда идет индустрия.
Прогресс неравномерен даже внутри «технических» областей. На тесте GPQA, где проверяется умение отвечать на сложные научные вопросы, модели год назад давали около 60% правильных ответов, сейчас приближаются к 90% — это выше результатов выдающихся ученых. Но на бенчмарке FrontierMath, где нужно решать оригинальные математические задачи, картина иная: GPT-5 решает 29% с одного прогона, 46% после 32 запусков, а совокупно десятки моделей добираются до 57%. Авторы теста оценивают потолок даже при бесконечных попытках в менее 70%. Модели упираются в стену там, где требуется настоящее рассуждение, а не воспроизведение выученного. Цифра «пять тысяч человек» — тоже скорее образ, чем точный подсчет: методологии, по которой Карпати ее получил, он не приводит. Но порядок величины важен сам по себе.
Позиция самого Карпати за год изменилась заметно. В октябре 2025-го он дал интервью, где назвал обучение с подкреплением «ужасным», нынешних агентов — «полным дерьмом», а приход настоящего AGI оценил не раньше чем через десять лет. Год спустя он описывает системы, которые совершают научные открытия и взламывают Hugging Face. Возможны два объяснения: либо за год произошел радикальный скачок, либо Карпати смещает публичную позицию. Оба правдоподобны. При этом его скепсис к фундаментальному подходу никуда не делся: «Reinforcement learning ужасен. Просто всё, что было до него, ещё хуже» — эту фразу из того же интервью легко представить себе и сегодня.
Есть в этой истории и бытовой маркер скорости изменений. Сам Карпати писал: «Менее года назад я писал код вручную, вводя команды в редактор символ за символом и время от времени нажимая Tab для автозаполнения небольших фрагментов кода». Человек, который учил нейросети программировать, еще год назад программировал «вручную» — а теперь описывает системы, где тысячи агентов неделями работают над проектами без участия человека. Конкретный пример такой работы: агенты OpenAI атаковали платформу Hugging Face, и анализ этой атаки занял месяцы.
OpenAI фиксирует и сдвиг в поведении обычных пользователей: переход от информационных запросов к прикладным задачам — программированию, аналитике, написанию текстов. Страны Латинской Америки показывают самые быстрые темпы роста использования на душу населения, догоняя Северную Америку и Европу. Воронка не статична. Но рост идет в основном из группы «никогда не пользовался» в группу «иногда пользуюсь», а не из «иногда» в «профессионально».
Если вы хотите понять, куда движется технология, смотреть на ChatGPT в браузере — плохая стратегия. Инструменты вроде OpenAI Codex и Claude Code дают более честную картину. Но и она неполна: FrontierMath показывает, что за пределами примерно 70% задач на глубокое рассуждение модели упираются в потолок, который не преодолевается ни увеличением попыток, ни привлечением новых моделей. Есть и другой failure mode: исследование «Brain Rot» продемонстрировало, что дообучение LLM на низкокачественных «вирусных» текстах ведет к деградации рассуждений, работы с длинным контекстом и безопасного поведения. Сильные методы коррекции устраняют последствия лишь частично. Прогресс не гарантирован — он может откатываться.
Карпати в том самом интервью сформулировал свой главный страх: не бунт машин, а то, что люди незаметно перестанут принимать решения. Это прямое продолжение его же воронки. Чем больше задач делегируется агентам, тем меньше людей понимает, что происходит, — и разрыв в доступе превращается в разрыв в понимании. Пять тысяч человек, имеющих доступ к самым мощным системам, будут принимать решения за миллиарды, которые видят только чат-бота. Экспонента реальна. Но она не для всех — и это не баг, а то, как индустрия устроена.